Якщо ви працювали з Laravel Excel або Fast Excel, цілком імовірно, що ви з цим стикалися. Різниця в тому, що один пакет часто змушує поборотися, перш ніж ви знайдете рішення, а другий з самого початку розрахований на те, щоб бути легшим, коли набір даних стає великим.
Це не посібник для початківців на тему «як експортувати дані в Excel» - ми припускаємо, що ви вже користувалися одним із цих пакетів. Ми розглянемо конкретніше питання: коли Fast Excel справді доречніший за Laravel Excel, а коли навпаки - особливо якщо ви експортуєте звіти з кількістю рядків, що лякає: від сотень тисяч до мільйонів.
Два пакети, дві різні філософії
Перед прямим порівнянням варто зрозуміти, на чому саме побудований кожен пакет, адже це пояснює, чому вони так по-різному поводяться, коли набір даних зростає.
Fast Excel, своєю чергою, побудований на Spout/OpenSpout. Його документація відверто окреслює межі можливостей: пакет називає себе «Laravel-flavoured Spout», швидшою та економнішою щодо пам'яті альтернативою Laravel Excel, але з набагато меншою кількістю функцій, і прямо рекомендує використовувати його «лише для простих завдань».
Цього розрізнення вже достатньо, щоб зрозуміти, куди рухається це порівняння. Йдеться не про те, який пакет «кращий» в абсолютному сенсі, а про компроміс між повним набором функцій і чистою ефективністю.
Чому базова архітектура важлива для великих наборів даних
PhpSpreadsheet, рушій Laravel Excel, відомий глибиною своїх можливостей: складне стилізування, формули, діаграми, тонке керування клітинками. Ціна цієї глибини - внутрішній принцип роботи: перш ніж щось буде записано у файл, бібліотека будує повне представлення таблиці в пам'яті.
Spout та його наступник OpenSpout із самого початку проєктувалися з іншим пріоритетом: читати й записувати файли таблиць потоково, рядок за рядком, не тримаючи весь набір даних у пам'яті. Це головна причина, чому Fast Excel зазвичай легший для простих операцій читання й запису у великих обсягах.
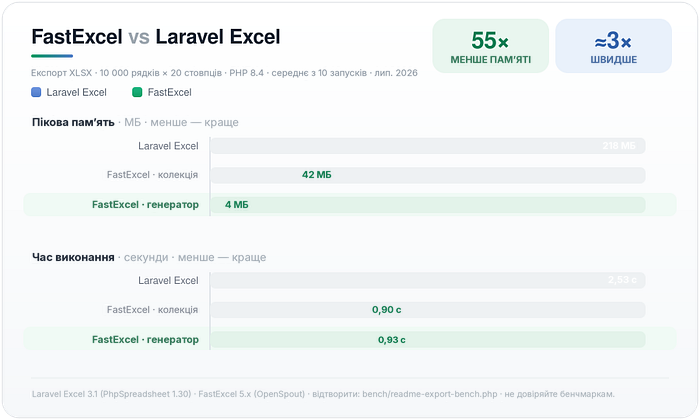
Щоб підкріпити це цифрами, а не просто вірити на слово, скористаємося результатами бенчмарків з README самого Fast Excel. Експорт 10 000 рядків × 20 колонок випадкових даних (тест на PHP 8.4):
- Laravel Excel 3.1 - пікове використання пам'яті 218 МБ, час виконання 2,53 с
- Fast Excel (з колекції) - пікове використання пам'яті 42 МБ, час виконання 0,90 с
- Fast Excel (з генератора/потоково) - пікове використання пам'яті 4 МБ, час виконання 0,93 с
Різниця суттєва: потоковий режим Fast Excel може зменшити споживання пам'яті в десятки разів порівняно з Laravel Excel. Проте варто зауважити: ці цифри взято з документації самого пакета, тож сприймайте їх як орієнтир, а не гарантію для вашого конкретного набору даних - різна структура даних дасть різні результати.
Реальний випадок: експорт мільйонів рядків
Тепер про те, що справді важливо, якщо ви щодня працюєте з одним із цих пакетів: що робити, коли потрібно експортувати щомісячний звіт про транзакції на мільйони рядків, а фінансовий відділ не хоче чути, що «сервер зайнятий»?
Підхід Fast Excel
Продуктивність Fast Excel у сценаріях із великими наборами даних зводиться до двох речей: передати йому ліниве джерело даних (таке, що не завантажується в пам'ять повністю наперед) і уникати методів, які змушують буферизувати дані, як-от transpose().
Якщо ви експортуєте безпосередньо з Eloquent, замініть get() або all() на cursor():
use Rap2hpoutre\FastExcel\FastExcel;
use App\Models\Transaction;

(new FastExcel(Transaction::cursor()))->export('transaction-report.xlsx');
Якщо джерело даних не є запитом Eloquent - наприклад, ви об'єднуєте дані з кількох таблиць або API - так само спрацює звичайний PHP-генератор:
function transactionRows()
{
  foreach (paginatedTransactionSource() as $row) {
    yield $row;
  }
}

(new FastExcel(transactionRows()))->export('transaction-report.xlsx');
Для імпорту великого файлу зі звітом прямо в базу даних шаблон схожий - просто переконайтеся, що ваш колбек повертає null, щоб оброблені рядки не накопичувалися в пам'яті:
(new FastExcel)->import('incoming-report.xlsx', function ($line) {
  Transaction::create([
    'reference' => $line['Reference'],
    'amount'    => $line['Amount'],
  ]);

  return null;
});
Або, якщо вам усе ж потрібен доступ до колекції, але при цьому пам'ять має залишатися стабільною, importLazy() - це золота середина: він повертає LazyCollection, яку можна обробляти частинами:
use Illuminate\Support\LazyCollection;

(new FastExcel)->importLazy('incoming-report.xlsx')
  ->chunk(1000)
  ->each(function (LazyCollection $chunk) {
    Transaction::insert($chunk->all());
  });
Підхід Laravel Excel
Laravel Excel теж має власну відповідь для великих наборів даних, але з іншою філософією: це не чисте потокове опрацювання, а автоматичне розбиття запиту на частини плюс можливість винести весь процес у фонову чергу.
Для експорту ви реалізуєте FromQuery замість FromCollection. Під капотом Laravel Excel автоматично розбиває цей запит на частини під час виконання, тож вам не потрібно вручну піклуватися про пагінацію:
namespace App\Exports;

use App\Models\Transaction;
use Maatwebsite\Excel\Concerns\FromQuery;
use Maatwebsite\Excel\Concerns\Exportable;

class TransactionsExport implements FromQuery
{
  use Exportable;

  public function query()
  {
    return Transaction::query()->orderBy('created_at');
  }
}
Оскільки цей клас експорту використовує трейт Exportable, ви також можете поставити весь процес у чергу, щоб він не блокував HTTP-запит, який його ініціював:
(new TransactionsExport)->queue('transaction-report.xlsx');
Для великих імпортів підхід схожий: поєднайте WithChunkReading, щоб читати файл пакетами, з WithBatchInserts, щоб запис у базу даних відбувався пакетами, а не рядок за рядком.
То який пакет обрати?
Замість того, щоб змушувати вас обрати один пакет раз і назавжди, корисніше сприймати їх як два інструменти в одному наборі: ви берете той, що підходить для поточного завдання.
Fast Excel зазвичай доречніший, коли:
- Завдання - простий табличний експорт/імпорт без складного стилізування чи макета
- Набір даних великий (від сотень тисяч до мільйонів рядків), а пам'ять сервера - реальна проблема
- Вам потрібна легка залежність із передбачуваною поведінкою і без зайвої «магії» під капотом
- Процес може виконуватися синхронно, без налаштованої інфраструктури черг
Laravel Excel зазвичай доречніший, коли:
- Вам потрібен повний набір функцій: експорт із кількома іменованими аркушами, детальне стилізування, експорт із Blade-представлення або інтеграція з Nova
- Імпорт потребує суворої валідації кожного рядка з чіткою обробкою помилок для тих, що не пройшли перевірку
- Інфраструктура черг уже налаштована, і ви б радше винесли важку обробку у фонове завдання, ніж вручну оптимізувати використання пам'яті
- У вашій команді вже багато коду навколо екосистеми Laravel Excel, тож повна міграція на Fast Excel не варта зусиль
Варто підкреслити: більші «сирі» показники Laravel Excel автоматично не роблять його «програвшим». Якщо ваша система черг надійна, додаткову пам'ять і час виконання може взяти на себе фоновий воркер, а користувачі все одно отримають плавний досвід. Перевага Fast Excel по-справжньому проявляється, коли у вас немає залежності від черги або ви її не хочете, але все одно потрібне щось легке й швидке.
Комбінація, яку легко недооцінити
Один підхід, про який говорять недостатньо: не обов'язково обирати один пакет для всього застосунку. Доволі поширена практика - використовувати Laravel Excel для експортів зі складним стилізуванням і шаблонами, як-от офіційні рахунки чи фінансова звітність, а Fast Excel залишити для окремої кінцевої точки з великим обсягом сирих даних, наприклад вивантаження для внутрішньої аналітики.
Так ви не змушуєте один пакет обробляти всі сценарії, коли вимоги до них насправді дуже різні.
Підсумок
Дискусія «Fast Excel чи Laravel Excel» - це лише чергова версія класичного інженерного компромісу: повний набір функцій проти чистої продуктивності. Єдиної правильної відповіді для всіх немає - вибір залежить від реальних обмежень вашого застосунку: наскільки великий набір даних насправді, чи готова інфраструктура черг і наскільки складним має бути результат для вашої команди чи клієнтів.
Якщо ви плануєте рефакторинг функції експорту, яка починає працювати важко, найбезпечніший перший крок - профілювання: перевірте, наскільки великий ваш реальний набір даних, а потім порівняйте обидва пакети у власному середовищі. Цифри бенчмарків у документації - корисна відправна точка, але остаточно вирішує, який пакет підходить, саме структура ваших даних.