Це переказ статті Ando Hakobyan Your Laravel queue workers keep 8 copies of your app in memory - зі збереженням його структури, цифр і коду.
Автор додавав воркери Horizon на 2 ГБ інстанс Laravel Cloud, доки пам'ять не заповнилася приблизно на 90%. Вийшло 27 воркерів. Потім він змусив воркери ділити між собою скомпільований код і повторив тест: той самий сервер, той самий застосунок, ті самі 600 завдань на хвилину. Цього разу сервер витримав 210 воркерів.
Це був тест пам'яті, а не швидкості: за такого темпу завдань процесор ніколи не ставав вузьким місцем, а пам'ять - ставала. Щоб запустити ті самі 210 воркерів у стандартному режимі, знадобився інстанс на 16 ГБ.
Усе почалося з того, що кілька серверів автора сиділи у swap, і чималу частину пам'яті на них займав саме Horizon.
Кожен воркер завантажує весь застосунок
Кожен queue:work - це окремий PHP-процес. Так само окремим процесом є кожен воркер Horizon і, що здивувало автора, кожен супервізор Horizon. Кожен із них завантажує Laravel і компілює код, якого торкається, у власну приватну пам'ять.
У прикладі конфігурації Supervisor з документації Laravel стоїть numprocs=8. Якщо ви його скопіювали, у вас вісім процесів, і кожен тримає власну копію того самого скомпільованого застосунку.
У бенчмарку автора в Docker стандартний воркер Horizon займав близько 63 МБ. Найцікавіше - супервізори. Супервізор ніколи не виконує завдань, він лише стежить за своїми воркерами, але все одно займав близько 56 МБ. Шість супервізорів - це приблизно 340 МБ ще до того, як виконалося перше завдання.
PHP-FPM розв'язав це багато років тому
FPM запускає один master-процес, налаштовує в ньому спільну пам'ять opcache і вже потім форкає воркери. Усі воркери FPM бачать ту саму спільну пам'ять, тож код, скомпільований одним воркером, повторно використовують усі інші.
Master-процес ніколи не завантажує застосунок - він лише володіє кешем. Як з'ясувалося, у цьому й полягає весь фокус.
Воркери черг нічого з цього не мають. Supervisord чи systemd запускає кожен php artisan queue:work як окремий, зовсім новий процес, і спільного батька, який володів би кешем, немає. Opcache у CLI за замовчуванням вимкнений. Якщо ввімкнути його через opcache.enable_cli=1, кожен процес отримає власний приватний кеш - і це все одно одна копія на воркер.
А opcache.file_cache, прогрітий у CI, економить час компіляції, але не пам'ять: кожен воркер однаково завантажує собі власну копію.
Перевірте свої сервери
Перш ніж вірити цифрам автора, подивіться на свої. Рахуйте PSS, а не RSS. RSS враховує спільну пам'ять повністю для кожного процесу, тож сума завищена. PSS ділить спільні сторінки між процесами, які їх використовують, і сума виходить чесною.
Запустіть скрипт від імені користувача, під яким працюють воркери (або через sudo):
for pid in $(pgrep -f '^[^ ]*php[^ ]* .*artisan (queue:work|horizon(:supervisor|:work)?)( |$)'); do
  awk '/^Pss:/ {print $2}' "/proc/$pid/smaps_rollup" 2>/dev/null
done | awk '
  { total += $1; count++ }
  END {
    if (count) printf "%d processes, %.0f MB total\n", count, total / 1024
    else print "No matching processes found"
  }'
Скрипт рахує також master і супервізори Horizon, бо пам'ять вони коштують так само. Якщо на одному сервері кілька застосунків, він складе їх усіх, тож за потреби звузьте шаблон.
Запишіть результат - це ваше «до». Яка його частина припадає на код, а яка на дані самих завдань, залежить від застосунку, і показати це може лише «після».
Чому не Go
Перенесення воркерів на Go розв'язало б проблему з пам'яттю - так зробили, наприклад, у Sentinel. Але в застосунках автора завдання і є застосунком: вони використовують ті самі моделі, сервіси й хелпери, що й усе інше. В одному застосунку 17 класів завдань тягнуть за собою приблизно половину кодової бази - близько 167 файлів із 400. Переписати це означає переписати пів застосунку, а потім тримати дві версії синхронними. Composer-пакет виявився дешевшим рішенням.
Спершу fork, потім завантаження
Очевидне рішення на PHP - завантажити застосунок один раз і форкати воркери з нього. Проблема в тому, що діти успадковують. Кожен отримує відкриті сокети батька до бази даних і Redis, тож два воркери починають говорити через одне з'єднання. Кожен також стартує з тим станом, який залишило завантаження, а будь-який випадковий стан, ініціалізований до fork, може повторитися в кількох дітей.
Тому queue-prefork робить те саме, що master FPM: форкає ще до того, як з'являється застосунок. Маленький процес-шаблон стартує з opcache і без жодного коду застосунку. Кожен воркер форкається з нього і вже потім сам завантажує застосунок через звичайну точку входу artisan, як будь-який стандартний воркер. Перший воркер компілює код у спільний opcache шаблону, а всі наступні знаходять його вже готовим.
Кожен воркер, як і раніше, відкриває власні з'єднання і будує власний контейнер і конфігурацію. Спільний у них лише скомпільований код.
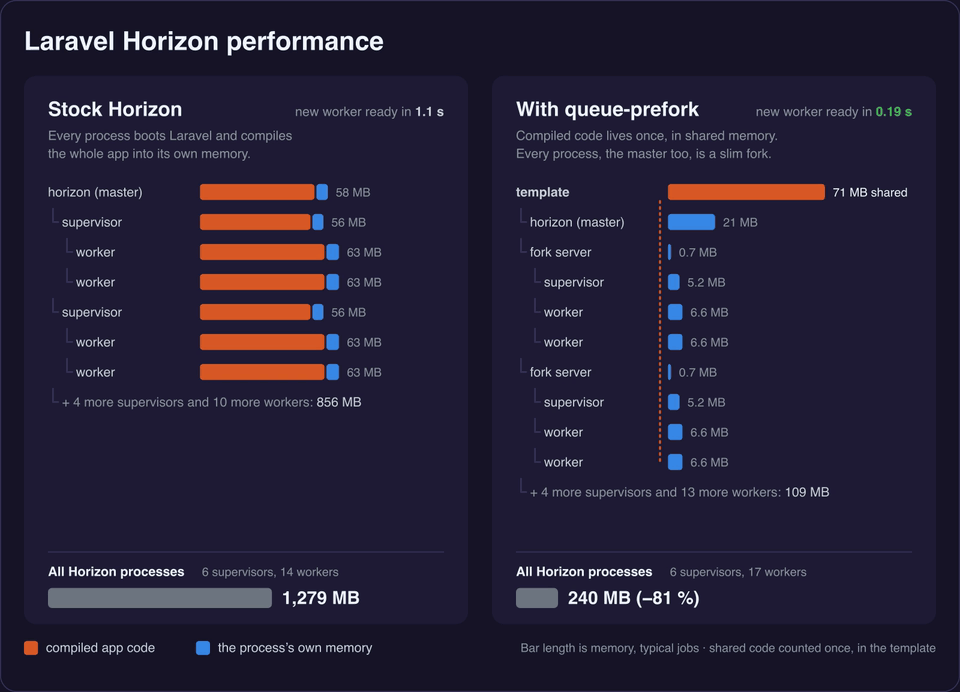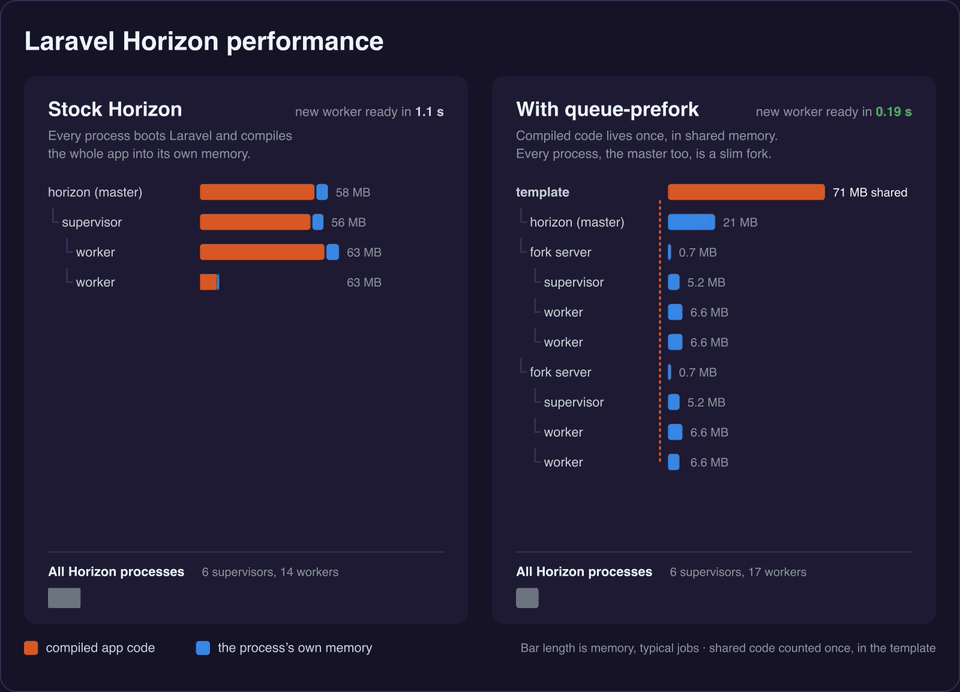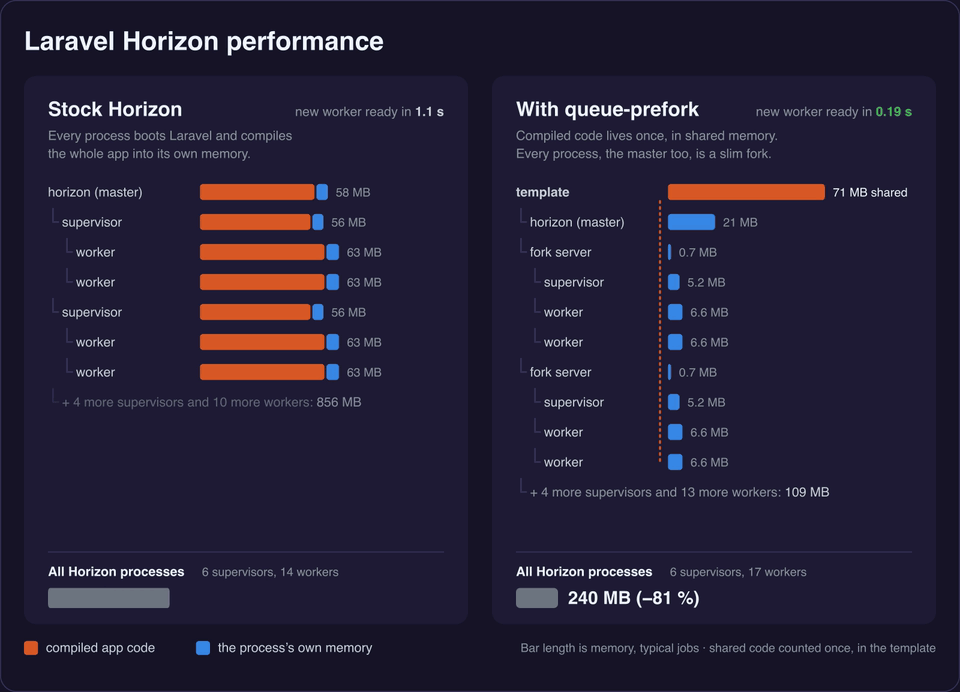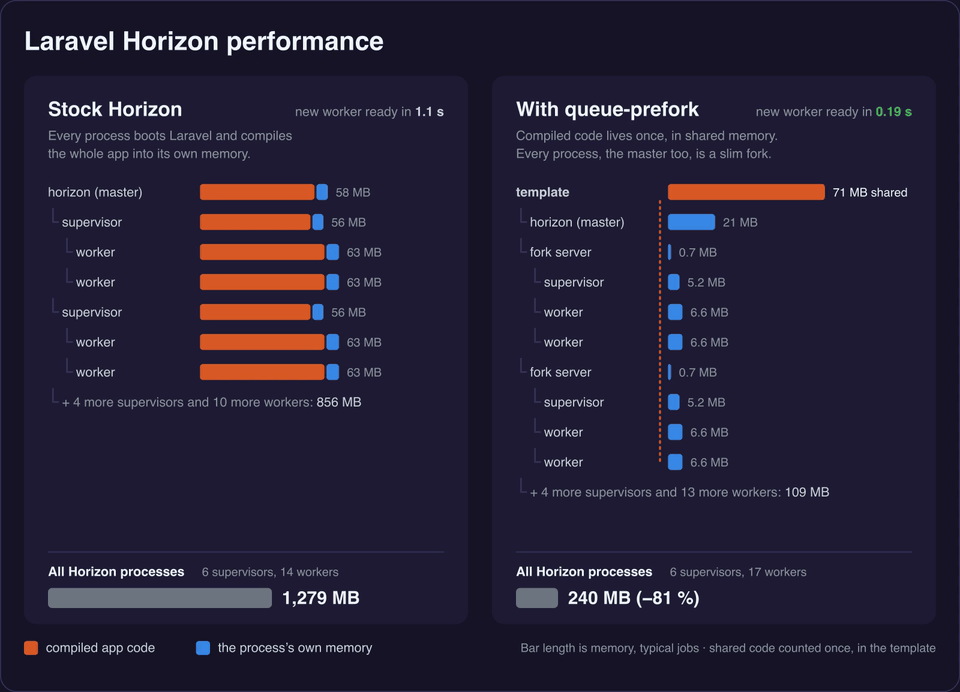
Для звичайного queue:work процес, який запустив supervisord, залишається крихітною заглушкою /bin/sh з тим самим PID. Менеджер процесів і далі ним керує, а queue:restart працює як завжди. З Horizon master, супервізори й воркери стають легкими форками. Подробиці - у README.
Цифри
Автор запустив поруч два однакові Docker-стеки на тому самому потоці завдань: Laravel 13.38 з приблизно 45 продакшн-пакетами, PHP 8.4 і Horizon 5.50.1 на віртуальній машині з 2 CPU. Пам'ять - медіана сумарного PSS із вимірюванням щохвилини. Цифри prefork включають його власні шаблони, заглушки й fork-сервери.
| Конфігурація |
Стандартно |
Prefork |
8 × queue:work, типові завдання |
645 МБ |
192 МБ (-70%) |
8 × queue:work, простій |
455 МБ |
102 МБ (-78%) |
8 × queue:work, важкі завдання |
1025 МБ |
524 МБ (-49%) |
| Horizon, 6 супервізорів з автомасштабуванням |
1279 МБ |
240 МБ (-81%) |
Horizon автомасштабувався в обох прогонах: у медіані до 14 воркерів у стандартному режимі і до 17 з prefork. Тобто prefork тримав більше воркерів у меншому обсязі пам'яті. Жодне завдання не впало, пропускна здатність була однаковою.
Навантаження на процесор теж знизилося - з 21,3% до 11,9% одного ядра для Horizon з типовими завданнями, бо новий воркер не перекомпільовує те, що вже є в кеші, а лише завантажує Laravel.
Важкі завдання економлять менше, бо їхні власні дані однаково приватні. Стандартний варіант працював з вимкненим opcache у CLI, як його постачає php.ini-production. На Laravel Cloud він увімкнений, тож там кожен стандартний воркер тримає ще й власний приватний кеш. Стенд для бенчмарку лежить у репозиторії, якщо захочете повторити.
Це тестове середовище. У реальному продакшені одна з конфігурацій Horizon автора зменшилася приблизно з 1,2 ГБ до приблизно 280 МБ.
Повернімося до сервера Laravel Cloud з початку статті. Там стандартний воркер коштував близько 56 МБ, а форкнутий - близько 7,4 МБ. Так 27 воркерів перетворилися на 210 на інстансі Flex 2 ГБ. Ті самі 210 воркерів у стандартному режимі зайняли 11 766 МБ, а найменший інстанс, куди вони вміщаються, - Pro 16 ГБ за $128 на місяць замість $24 (зате з 4 vCPU замість одного, хоча процесора за такого темпу завдань і так вистачало).
Чотири хвилини, які автор списав на свій код
На Cloud усі 210 воркерів з'являлися близько чотирьох хвилин, і автор був певен, що повільний його fork-сервер. Але стандартний Horizon поводиться так само - це стартовий розгін самого Horizon.
Супервізор стартує з floor((minProcesses + maxProcesses) / 2) воркерів. Далі він додає balanceMaxShift воркерів (за замовчуванням 1) кожні balanceCooldown секунд (за замовчуванням 3). А з balance => 'simple' параметр 'processes' => N задає лише максимум - мінімум лишається 1.
Тож супервізор на 150 воркерів стартує зі 75 і ще майже чотири хвилини добирає решту. Це поведінка Horizon 5.50.1, інші версії автор не перевіряв. Щоб отримати весь пул одразу:
'balance' => 'simple',
'processes' => 150,
'minProcesses' => 150,
З балансуванням auto натомість збільште balanceMaxShift.
Це працює і зі стандартними воркерами, але тоді кожен воркер компілює застосунок одночасно з іншими, а це чимале разове навантаження на процесор. З форкнутими воркерами це дешево. У тесті на 2 CPU 100 воркерів були готові приблизно через 1,7 секунди після старту супервізора проти 8-14 секунд у стандартному режимі. На великій багатоядерній машині, де стандартний варіант мав би показати себе краще, автор цього не перевіряв.
Як спробувати
Пакет розрахований на Linux-сервери з Laravel 11-13, PHP 8.2+ і, якщо ви його використовуєте, Horizon 5.23+. Він не допоможе, коли в кожному контейнері чи поді працює один воркер (зокрема керовані черги Laravel Cloud і Vapor): ділитися нема з ким. Воркер, що працює як PID 1 у Docker, лишається стандартним, тож дайте контейнеру init (init: true).
composer require tevkert/queue-prefork
php artisan queue-prefork:doctor    # на сервері воркерів: як працюватимуть ваші воркери і чому
php artisan queue-prefork:status    # пам'ять зараз, ваш стандартний стан «до»
Пакет вмикається одразу після встановлення для воркерів, запущених після цього. Розгорніть код, перезапустіть воркери через queue:restart або horizon:terminate, дайте їм прогрітися і запустіть status ще раз - це ваше «після».
Якщо якась перевірка безпеки не пройде, наприклад, розширення відкрило сокети чи потоки під час старту, воркери просто працюватимуть у стандартному режимі, а пакет запише в лог причину. Щоб вимкнути пакет, встановіть QUEUE_PREFORK=false, перекешуйте конфігурацію і перезапустіть воркери.
На Laravel Cloud запускайте Horizon як власний фоновий процес командою php -d grpc.enable_fork_support=1 artisan horizon.
Пакет поширюється під ліцензією MIT і доступний на GitHub.
Підсумок
Автор просить читачів поділитися своїми цифрами: скільки воркерів працює на сервері, що показує скрипт і які завдання вони виконують, - бо поки що він міряв лише власні застосунки.
Від нас: навіть якщо пакет вам не потрібен, скрипт підрахунку PSS і налаштування minProcesses для Horizon варто взяти собі вже зараз. А сам queue-prefork з'явився лише кілька днів тому (v1.0.x), тож спершу виміряйте своє «до», перевірте пакет на staging і лише потім вмикайте на продакшені.